 Экосистема сервисов аналитики
цифровых данных в строительстве
Экосистема сервисов аналитики
Для рабочих агентов я выбираю минимальный класс модели, который способен самостоятельно довести задачу до проверяемого результата. Эта граница хорошо видна на строительных данных: агенту недостаточно вызвать инструмент по готовой инструкции. Ему приходится выяснять, как устроена конкретная BIM-модель, находить нужные элементы и определять, какие свойства отвечают на вопрос пользователя. Когда модель уже справляется с такой работой, дальнейший выбор определяется стоимостью выполнения и поведением в длинном сценарии.
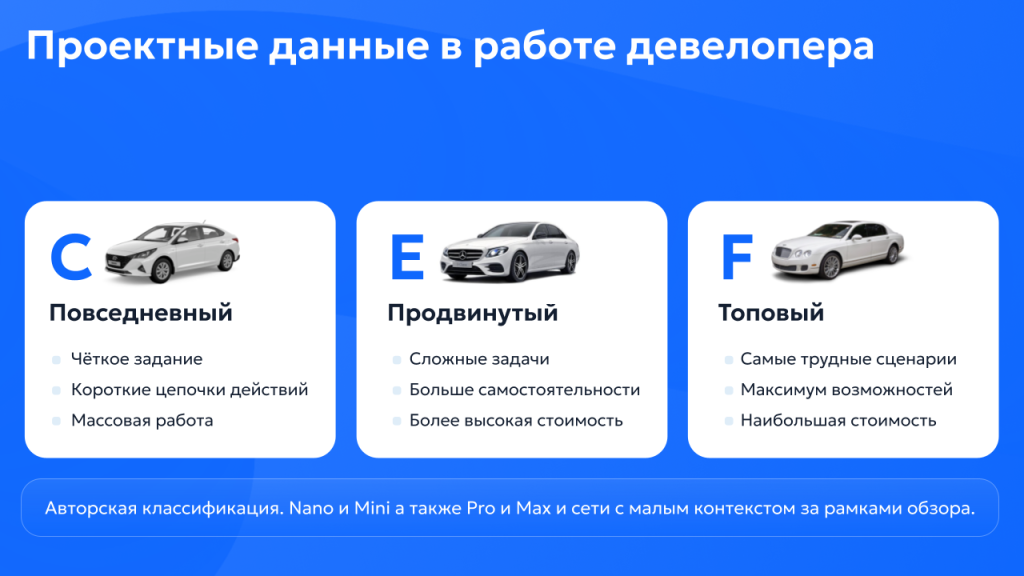
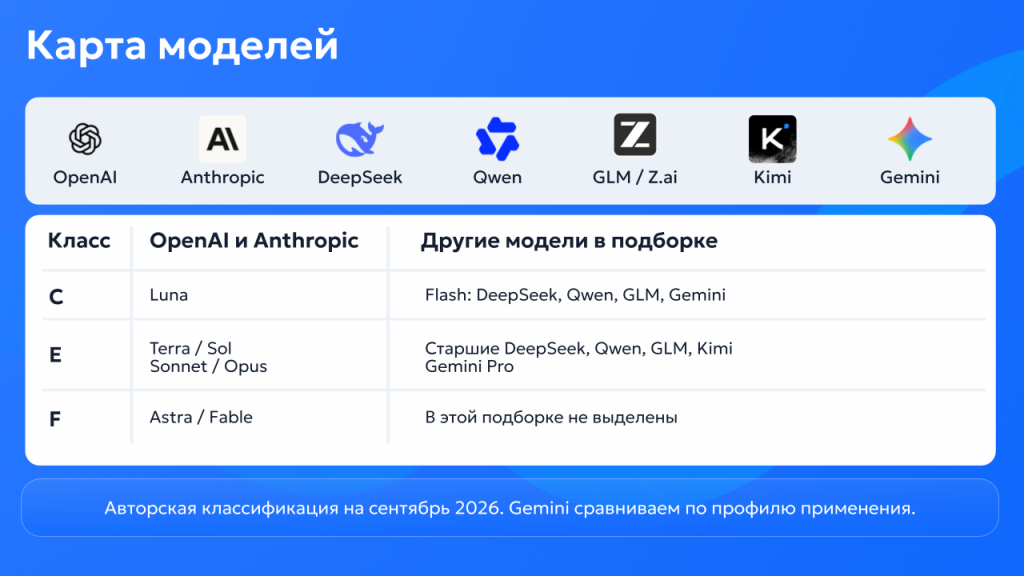
Сравнение отдельных версий быстро устаревает. Поэтому мне полезнее рассматривать когорты с похожим уровнем возможностей и экономикой применения. В этой статье я использую условные классы C, E и F по аналогии с автомобилями. Примеры семейств соответствуют подборке моего доклада на сентябрь 2026 года, а сам подход рассчитан на более длительное применение. При смене поколения моделей нужно заново проверять представителей классов, сохраняя критерии оценки.
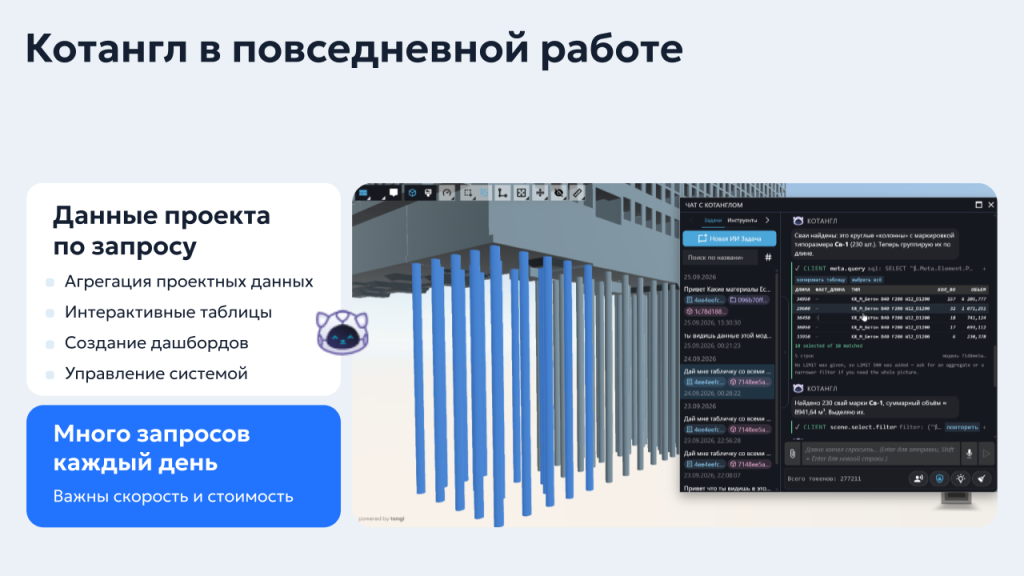
Мы ежедневно тестируем агентов на множестве разных кейсов работы со строительными данными. Свайное поле — один из тестов, к которому мы регулярно возвращаемся. По сложности он занимает промежуточное место, а интересен небольшой особенностью устройства модели. На его примере удобно объяснить, как агент исследует неизвестные ему данные. Тот же принцип работы применим и к другим задачам.
В этом примере по модели монолитного каркаса нужно было собрать сведения о свайном поле: определить длины свай и их количество, подготовить таблицу. Мы не объясняли агенту, как распознать сваи и в каких параметрах искать длину. Ему предстояло самостоятельно исследовать модель.
В данных была существенная особенность: сваи моделировались как несущие колонны. При этом в той же категории находились другие колонны, которые сваями не являлись. Выбор всех фундаментов пропустил бы нужные элементы, а выбор всех несущих колонн дал бы лишние. Соответствие между инженерным понятием и категорией BIM-модели здесь нельзя было принять как готовое правило.
Такая постановка требует эвристического исследования. Агент должен сформировать предположение о том, где находятся сваи, получить данные для его проверки и уточнить выборку. После этого необходимо определить источник длины и собрать результат. Важен весь переход от пользовательского понятия «свайное поле» к конкретным элементам и их значениям. Конкретный набор признаков зависит от устройства проекта.
В Tangl это исследование опирается на базовые принципы работы с неизвестной моделью. Сначала агент выясняет, какие свойства вообще встречаются у её элементов. Затем анализирует названия свойств и выбирает те, которые могут быть полезны для поставленной задачи. Это позволяет начать работу без заранее заданного соответствия между инженерным понятием и конкретным параметром проекта.
Далее агент использует интересующие его свойства, чтобы находить наборы элементов, и запрашивает у них нужные значения. Полученную выборку он анализирует: отвечает ли она вопросу пользователя и достаточно ли данных для результата. Если выборка не устраивает, агент делает уточняющие запросы. Такой цикл может включать несколько шагов, пока не станет понятно, какие элементы отбирать и на какие свойства опереться.
Для свайного поля этот способ работы позволяет исследовать элементы независимо от исходного ожидания, что сваи должны находиться в категории фундаментов. Агент знакомится с фактическим содержимым модели и уточняет способ получения таблицы. Пользователю не требуется до начала работы знать, где именно автор проекта разместил нужную информацию.
Ход исследования виден в чате Tangl. Пользователь может раскрыть отдельный шаг и посмотреть, чем занят агент и как получает данные, либо дождаться итогового результата. Для сравнения моделей такая наблюдаемость особенно полезна: видно, какая из них быстрее нашла подходящие свойства, а какая продолжает уточнять выборку или повторяет уже выполненные действия.
В этом тесте модели уровня Mini и Nano из проверенного нами набора не справлялись. Инструкции агентской системы были доступны, однако модели не могли выстроить нужное исследование и получить результат. Это показало, что наличие инструментов и инструкций само по себе ещё не обеспечивает достаточную самостоятельность.
Модели уровня Flash начинали справляться с задачами такого уровня. Способность провести подобное исследование стала нижней границей отбора в нашу когорту C. Все включённые в неё модели справлялись с такими сценариями, хотя одним требовалось больше шагов, другим меньше. В описанном тесте более дорогие модели из старших когорт также получали результат.
Отбор в нашу когорту C опирается на способность решать подобные задачи, а оценку пригодности мы формируем по разным кейсам. Свайное поле здесь служит иллюстрацией процесса исследования. Из этого примера не следует, что любая модель с названием Flash автоматически умеет работать с BIM-данными. Внутри прошедшей отбор группы мы дополнительно сравниваем корректность результатов, число действий, время и расходы.
В агентской системе языковая модель получает задание, выбирает доступные действия, интерпретирует ответы инструментов и определяет следующий шаг. Её пригодность зависит от того, насколько сложную последовательность она может выстроить без подробного сценария от пользователя. Кейс со сваями показывает, что даже сравнительно простая итоговая таблица может потребовать содержательного исследования.
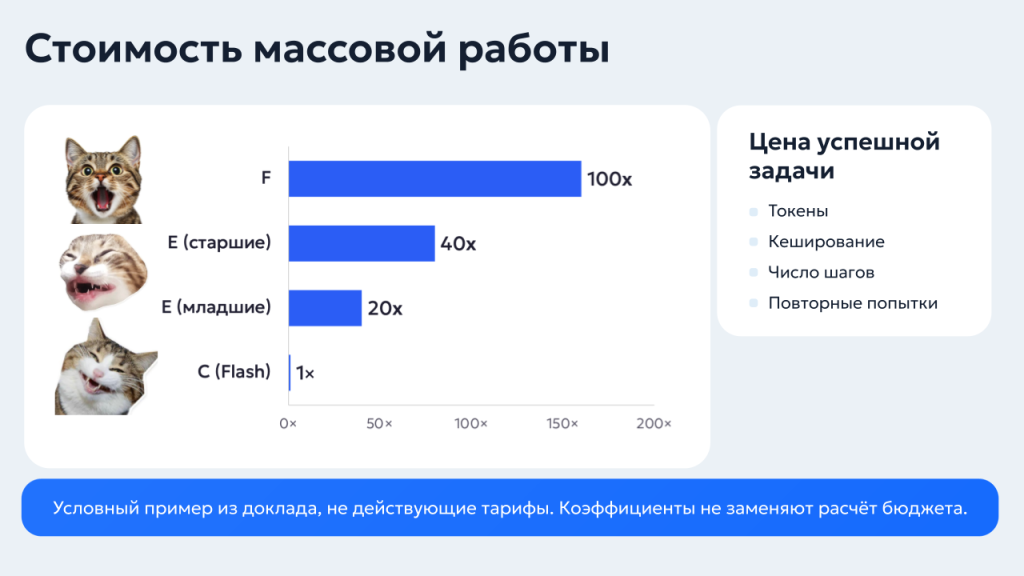
Расход на модель складывается из оплачиваемого входа и выхода во всех обращениях сценария. На входе могут действовать разные условия для нового и кешированного контекста. Сравнение требует учесть настройки рассуждения и другие тарифицируемые компоненты, если они предусмотрены провайдером. Подставлять единую условную цену токена для всего сценария недостаточно.
В многошаговой работе имеет значение траектория агента. В тесте со сваями одни модели делали больше действий, чем другие. Каждый лишний запрос может добавить оплату модели, ожидание инструмента и новые данные в историю. При повторной попытке часть работы выполняется заново. Поэтому меньший тариф за токены не гарантирует меньших расходов на завершённое задание.
Для сопоставления полезно считать стоимость успешной задачи: общие расходы всех тестовых запусков, включая неудачные и повторные, делить на число результатов, прошедших заранее заданную проверку. Если проверку не прошёл ни один запуск, показатель не рассчитывается — кандидат ещё не доказал пригодность. Время специалиста на ручное исправление стоит учитывать отдельно, чтобы не скрывать эксплуатационные затраты.
Старший класс может быть выгоден, если устраняет ошибки или заметно сокращает число повторов. Если недорогая модель уже выдаёт правильную таблицу за приемлемое время, повышение класса нужно обосновать другим преимуществом. Для массовых операций такое различие особенно существенно: стоимость одного запуска переносится на весь объём регулярной работы.
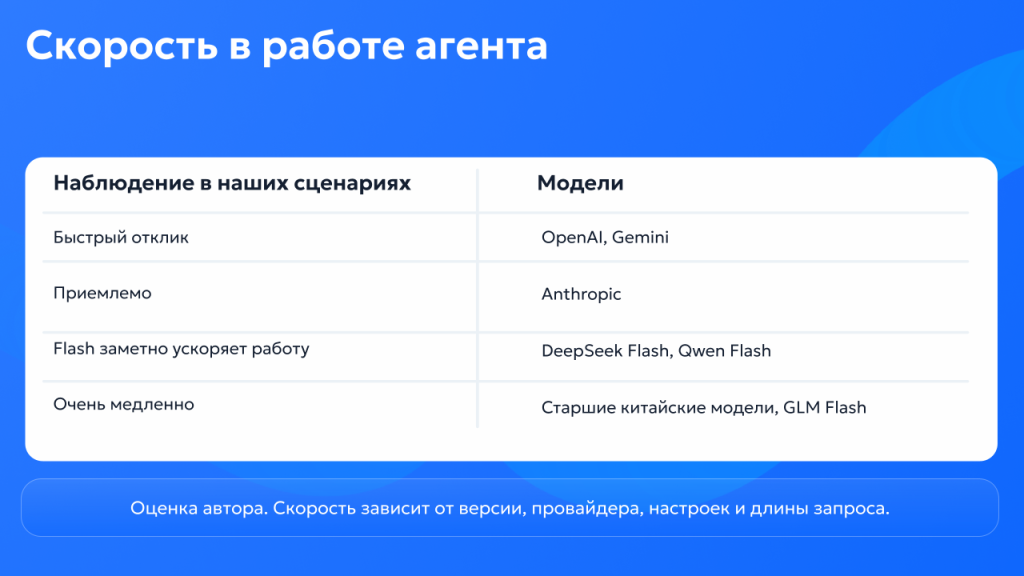
В моих сценариях OpenAI и Gemini дают быстрый отклик. Anthropic также подходит для интерактивной работы, хотя в наших условиях обычно отвечает медленнее. У старших китайских моделей мы чаще наблюдали задержки. Flash-версии DeepSeek и Qwen заметно ускоряли работу, но одного названия Flash недостаточно: GLM Flash в наших прогонах выглядел менее убедительно.
Это наблюдения при конкретных версиях, провайдерах и настройках. Переносить их на любую конфигурацию нельзя. Для сравнения полезно отдельно записывать полное время сценария, число обращений к модели и ожидание инструментов. Тогда видно, чем вызвана разница: длительностью ответа, избыточным исследованием или скоростью получения данных.
Повторные прогоны помогают увидеть устойчивость поведения. Для пользовательского диалога важны и типичное ожидание, и редкие длительные задержки. Для фонового аудита допустимая длительность может быть другой. Критерий скорости следует устанавливать для режима использования, в котором агент будет работать постоянно.
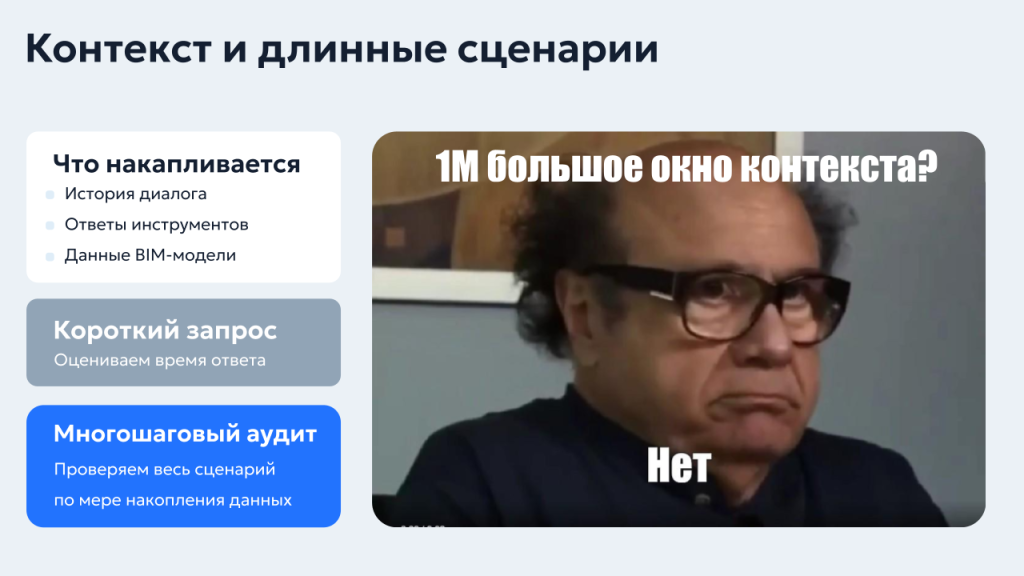
В длинном сценарии контекст растёт за счёт истории диалога и результатов инструментов. BIM-данные могут занимать значительный объём: агент получает перечни объектов, свойства, промежуточные выборки и итоги проверок. Это меняет условия работы по сравнению с коротким тестом в пустом чате.
Размер заявленного контекстного окна характеризует предельный объём данных, с которым может работать модель, но не гарантирует одинаковую скорость и качество на всей его длине. Нужно отдельно проверять, насколько модель замедляется и сохраняет ли важные условия к концу исследования. Особенно опасна ситуация, когда промежуточные ответы выглядят правдоподобно, а итоговая выборка уже не соответствует исходному запросу.
По моим наблюдениям Luna меньше замедляется в длинных сценариях, чем DeepSeek Flash. Поэтому для продолжительного аудита проекта я чаще начинаю с Luna. Эту оценку следует перепроверять при смене версии или провайдера, а короткий успешный тест не заменяет длинного прогона.
Часть решения находится в самой агентской системе. В Tangl мы уделяем внимание тому, какие данные получать и что сохранять в контексте. Для очередной проверки полезно возвращать из инструмента только необходимые сведения. При сокращении истории нужно сохранять условия задания и основания промежуточных выводов: уменьшение объёма не должно разрушать возможность проверить результат.
Неудачный ответ не всегда означает недостаточную мощность модели. Агент мог получить неполную выборку, не иметь нужного инструмента или неправильно понять условие. В истории со сваями ошибка могла возникнуть уже на первом предположении о категории элементов. Прежде чем переходить на дорогую модель, полезно понять, на каком шаге нарушилась логика исследования.
Журнал действий должен позволять увидеть, какие данные запросил агент, что получил и на каком основании сформировал итог. Если необходимые сведения недоступны, смена модели не решает проблему доступа. Если данные доступны, а агент не может выстроить исследование или корректно использовать результат инструмента, сравнение со старшим классом становится содержательным.
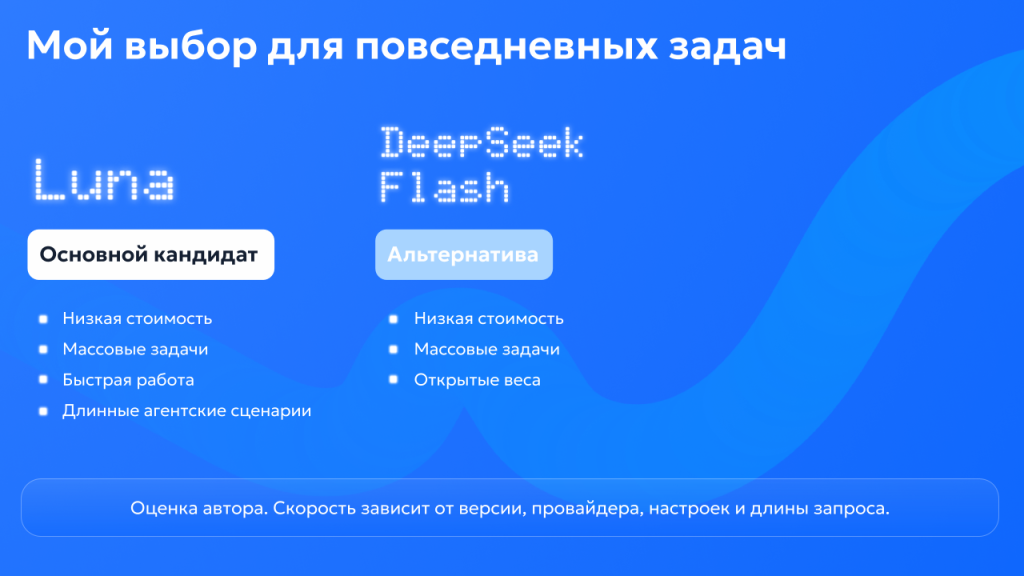
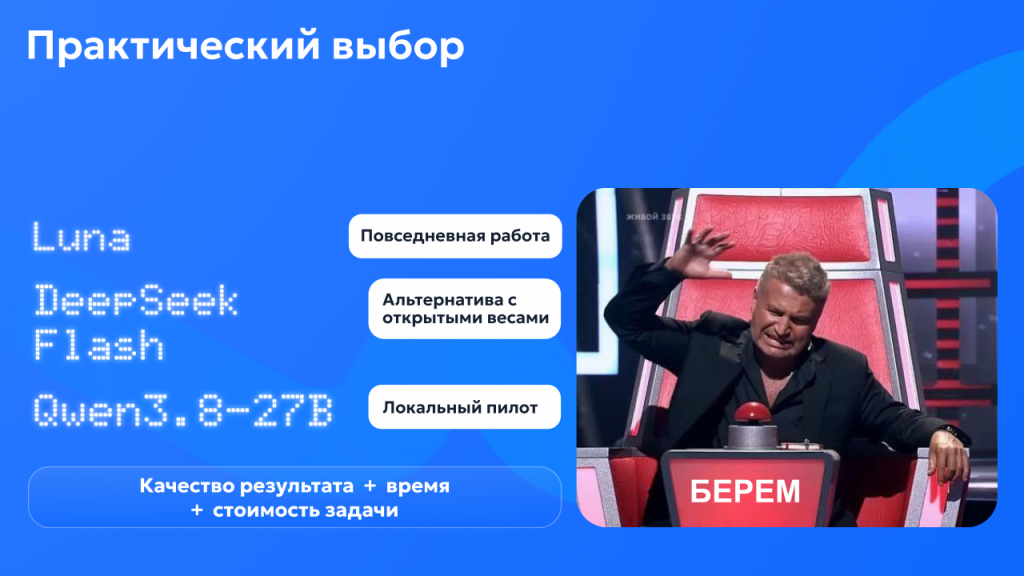
Для повседневных сценариев из моей подборки основным кандидатом остаётся Luna: её возможностей хватает для многих задач, а сочетание стоимости и скорости подходит для регулярной работы. DeepSeek Flash я рассматриваю как альтернативу, в том числе когда важны открытые веса. Qwen, GLM и Gemini также стоит проверять на конкретном сценарии и у выбранного провайдера.
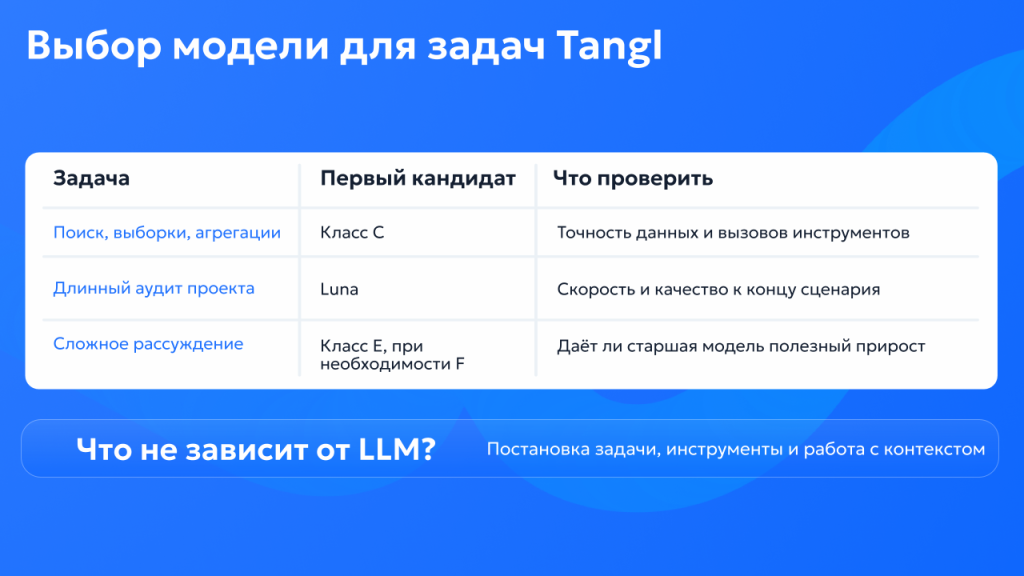
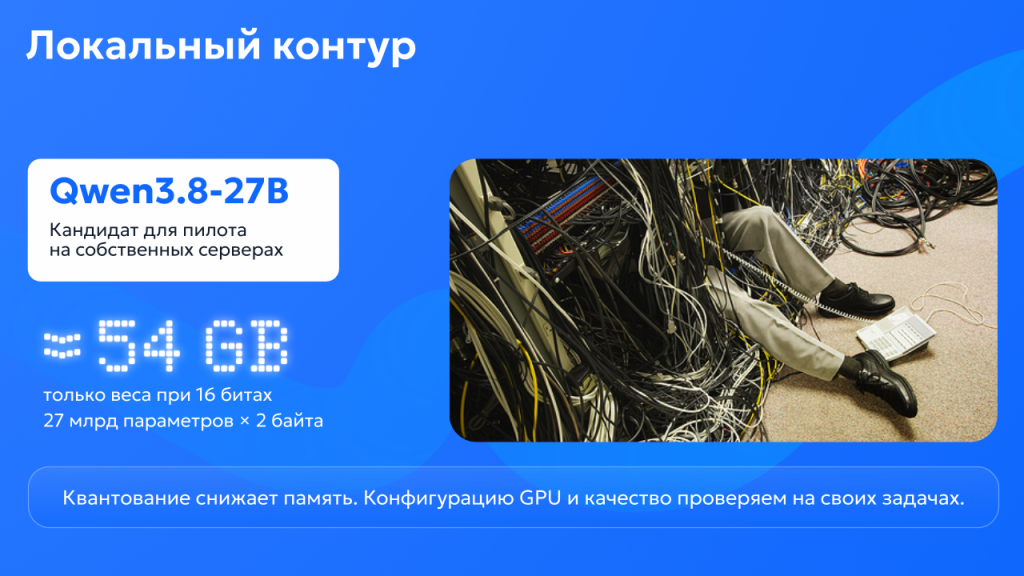
Для закрытого контура выбор начинается с доступного оборудования, длины рабочих запросов и необходимой параллельности. Открытые веса позволяют развернуть модель самостоятельно, но расходы на инфраструктуру и эксплуатацию требуют отдельного расчёта. В качестве начального кандидата для такого пилота я рассматриваю Qwen3.8-27B.
Оценка памяти для весов строится из числа параметров и точности их хранения. Для 27 миллиардов параметров при двух байтах на параметр получается 54 миллиарда байт: примерно 54 ГБ в десятичном представлении, или 50,3 ГиБ. Это объём самих весов, а не полная потребность в видеопамяти.
Сверх весов нужна память для KV-кеша, служебных буферов и других данных среды выполнения. KV-кеш хранит промежуточные ключи и значения механизма внимания. Его размер зависит от архитектуры и режима обработки, а увеличение длины контекста и числа одновременных запросов повышает требования. Поэтому ориентир около 60 ГБ из моего доклада нельзя считать гарантией работы при любой нагрузке.
Квантование уменьшает объём памяти, необходимый для весов. Конкретный формат нужно проверять на тех же заданиях, по которым выбирают модель: после изменения точности хранения важно сохранить способность исследовать данные и корректно вызывать инструменты. Следующим возможным кандидатом я рассматриваю DeepSeek Flash, однако для него в нашей постановке потребуется существенно более серьёзная инфраструктура.
Оставьте заявку, и мы проведем бесплатную консультацию по преимуществам Тангл для вашего бизнеса
Спасибо за вашу заявку! Свяжемся с вами в ближайшее время.
Спасибо за вашу заявку! Свяжемся с вами в ближайшее время.